Comment j’ai créé ma vidéo sur l’IA et l’eau avec Claude
Je prends toujours mon bain en discutant avec Claude. Un jour, je lui ai demandé si notre conversation consommait vraiment beaucoup d’eau. On en a débattu et c’est cet échange qui m’a donné l’idée du film.
Voir le film complet
Comparer deux montages
Choisissez un passage et deux versions. Un clic sur une image permet de l’agrandir.
Images tirées des huit exports. Les repères indiquent le temps dans chaque film ; un même plan peut avoir changé de place.
La chaîne de fabrication
Le film ne contient aucune image filmée. Chaque plan est dessiné par du code JavaScript, puis calé sur ma voix au centième de seconde. Voici les sept étapes, dans l’ordre où le film a été fabriqué. Elles ont produit huit montages, le 21 et le 22 octobre.
- TexteDicté puis relu8 versions
- VoixElevenLabs, clone de ma voix1 min 58
- CalageWhisper et alignement acoustique425 mots, 37 phrases
- Dessin7 agents Claude en JavaScript31 puis 32 plans
- RelecturePlanches et mesure de la lumière5 images par plan
- SonBruitages, musique, mixage−14,6 LUFS
- ExportPlaywright et FFmpeg1080 × 1920, 30 i/s
Étape 1. Le texte : j’ai remis deux mots
Avant les huit montages, il y a eu huit versions du texte. Je dictais les phrases, puis je relisais ce que Claude en avait fait. Dans une de mes dictées, « blablabla » voulait dire qu’il restait une phrase à écrire. « Et patati et patata » s’est retrouvé dans une proposition. Je l’ai enlevé. En revanche, quand la correction a fait disparaître mon « Bon allez », j’ai demandé qu’on le remette. Sans ces deux mots, on aurait dit que je commençais à lire un problème de maths.
« Une conversation moyenne avec ChatGPT, c’est plus ou moins 30 messages. »
« Bon allez, prenons une conversation moyenne avec ChatGPT, plus ou moins 30 messages. »
Étape 2. La voix : le calcul prenait un ton de tuto
Voici deux lectures de la première phrase, sans musique. La première est un essai avec Qwen. La seconde vient de la prise ElevenLabs que j’ai retenue. On peut écouter la façon dont chacune prononce « ChatGPT », et surtout ce qui se passe après « mais » : je voulais qu’on entende jusqu’au bout la même comparaison.
Phrase entendue dans les deux extraits : « On vous dit que l’IA gaspille de l’eau, mais votre café de ce matin a consommé 280 fois plus d’eau qu’une conversation avec ChatGPT. »
L’accroche m’allait déjà dans une première prise ElevenLabs. C’est plus loin, au moment de faire le calcul et de demander aux gens de s’abonner, que la voix prenait un ton de tuto. Pour la nouvelle prise, j’ai gardé le ton de l’intro et précisé les consignes : écrire « Gé Pé Té » pour la prononciation, laisser les nombres en chiffres et rappeler le ton documentaire juste aux endroits où il se perdait. C’est à l’écoute que j’ai choisi la prise de 1 min 58 qui sert au film.
Dans les fichiers du film, chaque phrase existe ensuite deux fois : « 280 » pour l’écran, « deux cent quatre-vingts » pour retrouver le mot dans l’enregistrement.
Étape 3. Caler chaque image sur un mot
Avec Claude, je suis passé directement à l’animation, sans storyboard à faire valider. La voix donnait déjà le rythme. Whisper a d’abord transcrit l’enregistrement. Un alignement acoustique a ensuite placé chacun des 425 mots dans le temps. La narration a été découpée en 37 phrases, et chaque plan démarre sur une phrase précise. Voici ce que donne une phrase, mot par mot :
{ "id": "E16b2",
  "text": "c'est-à-dire une petite bouteille d'Evian.",
  "words": [
    { "w": "une",        "t0": 0.68, "t1": 0.78 },
    { "w": "petite",     "t0": 0.86, "t1": 1.12 },
    { "w": "bouteille",  "t0": 1.16, "t1": 1.40 },
    … ] }
En lisant « on arrondit à un demi-litre, c’est-à-dire une petite bouteille d’Evian », j’entends une seule phrase. Mais elle contient deux choses à montrer. À partir du sixième montage, la piste de voix est coupée dans un silence. Le calcul reste sur l’ardoise pendant « on arrondit à un demi-litre ». La bouteille se pose sur « petite », 0,86 seconde après le début du second morceau. La phrase, elle, est restée entière.
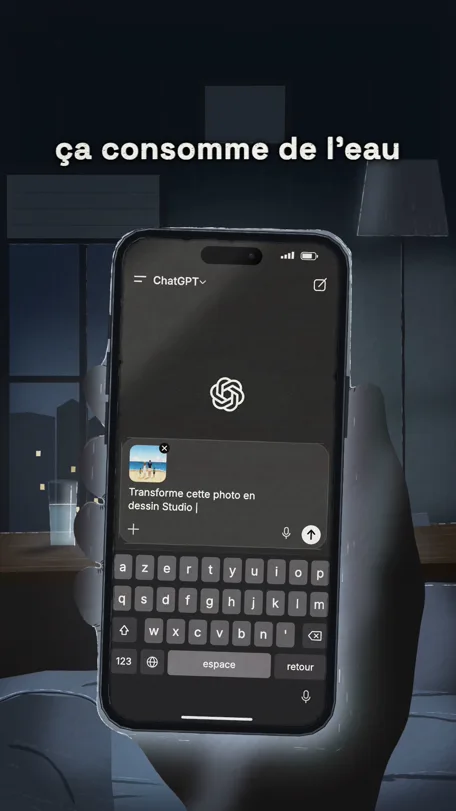
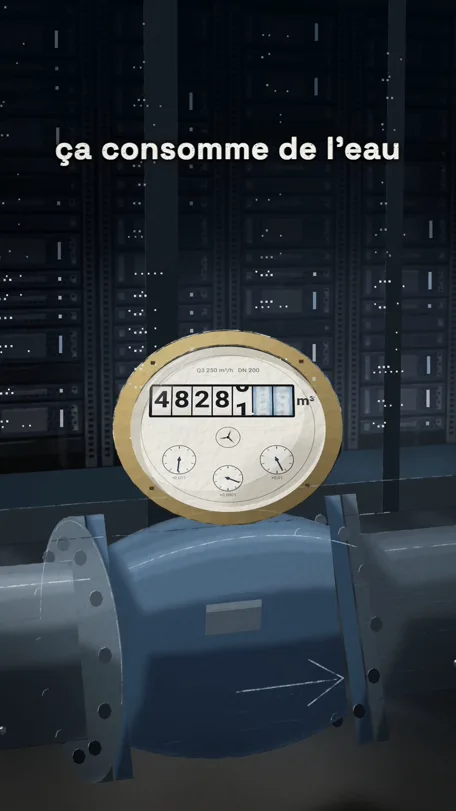
Le découpage a aussi reçu un nouveau plan en V6. Sur « Alors oui, l’IA, ça consomme de l’eau », on voyait déjà le téléphone de l’exemple suivant. La phrase a maintenant son image : un compteur de data center dont les rouleaux passent de 48 279 à 48 280 m³ sur « l’IA ».
Étape 4. Sept agents dessinent en parallèle
Pour le premier montage, les dessins étaient répartis entre sept agents, un par famille de décors ou d’objets. Chacun écrivait en JavaScript les plans de sa famille et rendait ses images de contrôle. Tous suivaient les mêmes règles du film : la cuisine, la bouteille, la façon de peindre l’eau.
- Data centertours, serveurs, sécheresse, campus
- ÉcransGhibli, régime, mail, conversation, abonnement, goutte
- Papierjournaux, étude, rotative, page censurée, calcul
- Mesuresbalance, verre, pipettes, cuillère
- Bouteillebouteille, table, cuve
- Cuisineouverture, vapeur, tasse, douche, fin
- Matièrescoton, teinture, jean, steak
Une planche réunit ensuite les images de chaque plan, avec son minutage et la phrase dite. Une tasse minuscule ou une scène trop sombre saute aux yeux, même quand le dessin pris isolément paraît correct.
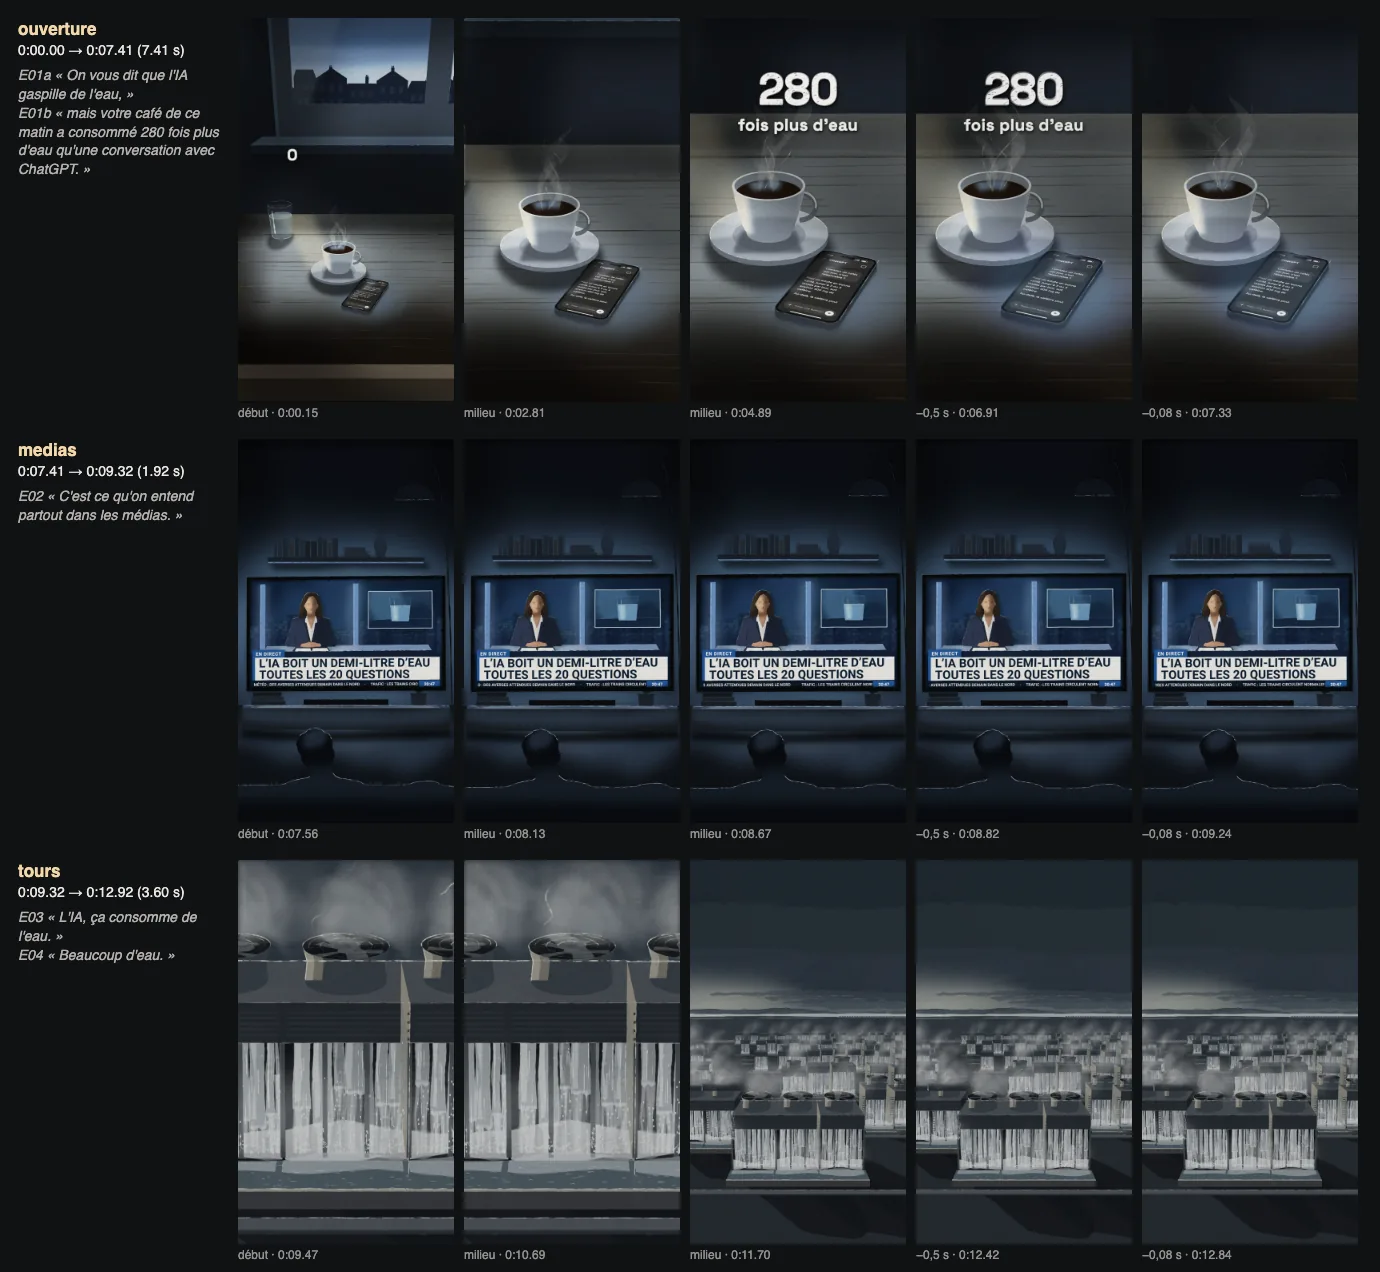
Étape 5. Mesurer la lumière plutôt que la deviner
Sur le premier montage, j’aimais certains plans de nuit. Mais dans le champ de coton, on distinguait à peine ce qui poussait.
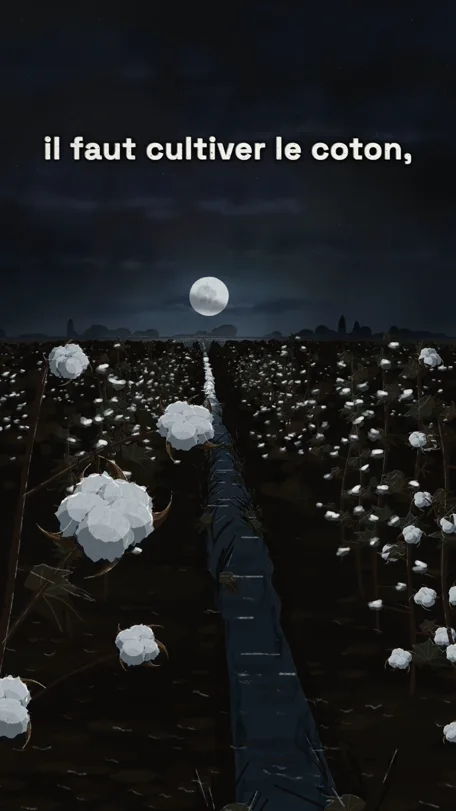
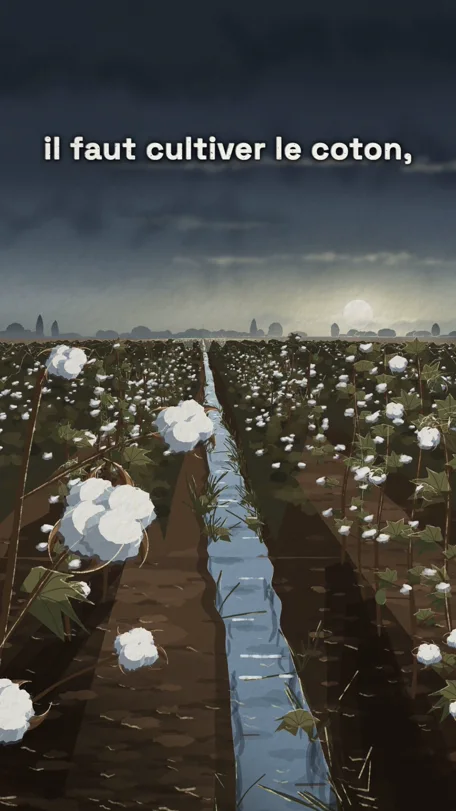
Pour ne pas juger seulement à l’œil, Claude a écrit un petit script qui mesure chaque image : la luminosité de la scène et celle de ses parties claires. Sous un seuil, il signale le plan à revoir.
En V3, on a remis de la nuit là où elle servait : un écran qu’on regarde seul, ou la chaleur orangée au-dessus des serveurs. La consigne utile n’était plus « éclaircis le film ». C’était de décider, pour chaque scène, ce qu’on devait voir en premier.
Étape 6. Le son : la douche s’arrêtait à la coupe
À l’image, il faut bien quitter la douche pour passer au champ de coton. À l’oreille, en revanche, l’eau s’arrêtait au changement de plan, comme si quelqu’un avait fermé le robinet. Dans le quatrième montage, j’ai fait utiliser des sons enregistrés. Celui de la douche se prolonge sur le plan du coton et s’efface en une seconde : dans le code, une simple « queue » de TAIL = 1.0 seconde ajoutée à chaque son d’eau qui dure. Écoutez le même raccord avec les bruitages seuls, sans la voix ni la musique.
Le plan change environ 2,5 secondes après le début de chaque extrait. Dans la V4, écoutez la seconde qui suit la coupe. Les deux pistes sont amplifiées de la même façon pour entendre les bruitages.
Il y a eu d’autres reprises que je n’aurais pas su demander avant de voir le film. La craie qui écrit le calcul, par exemple : une police manuscrite donne tout de suite la forme du chiffre. Une vraie main laisse d’abord un morceau de trait, puis un autre. En V4, le calcul se dessine trait par trait. Au montage suivant, j’ai fait garder des passages entiers d’un enregistrement d’écriture au tableau pour que le geste ait aussi son bruit.
Étape 7. Les retours : pourquoi les cuves ne suffisaient pas
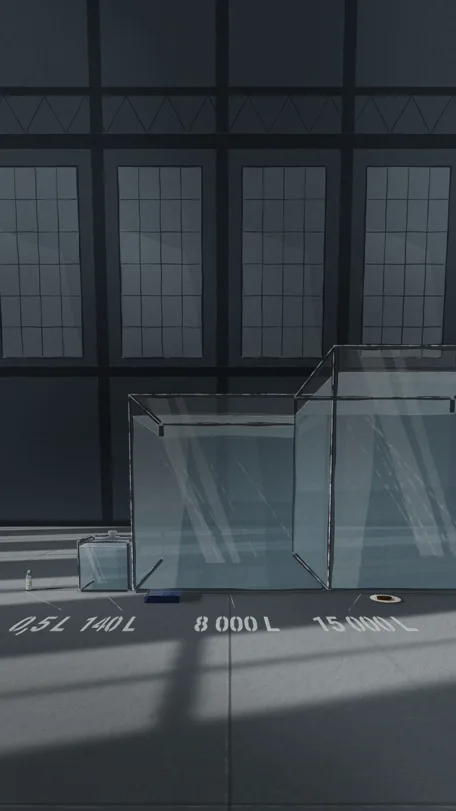
Je voulais répondre à une question : quand on dit que l’IA consomme « beaucoup d’eau », beaucoup par rapport à quoi ? Au début de la vidéo, je prends la tasse de café du matin. Plus loin viennent la douche, le jean qu’on enfile et le steak dans l’assiette. Dans le deuxième montage, la caméra partait d’une petite bouteille et reculait devant des cuves de plus en plus grandes. C’était une bonne image pour comparer des volumes. Sauf qu’à ce moment-là, j’avais déjà donné tous les chiffres.
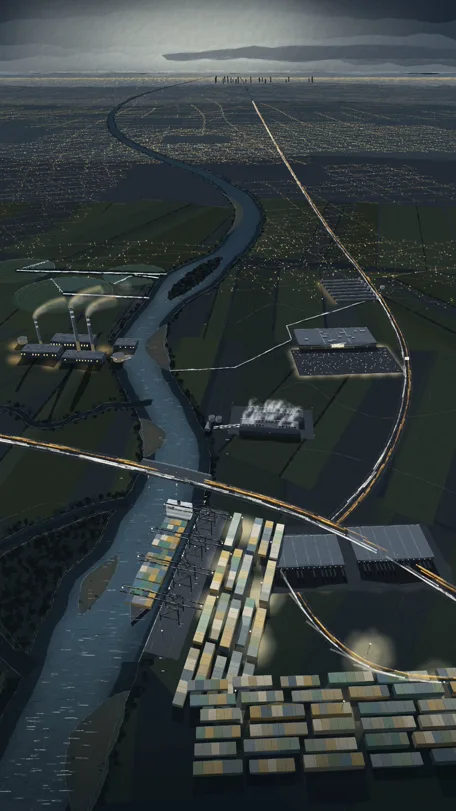
Ma dernière phrase, c’est « si la question de l’eau vous intéresse, c’est toute notre consommation qu’il faut revoir ». Pour la troisième version, j’ai demandé un paysage. On part toujours du data center. En reculant, on découvre un champ irrigué, des usines, une ville. Le data center finit par n’être qu’un bâtiment parmi les autres. En V5, j’ai aussi fait enlever le reflet du soleil : il dessinait un ruban blanc si régulier qu’on regardait surtout le fleuve. Je voulais qu’on regarde ce qu’il alimente.
Le café et la conversation restent une comparaison à lire avec précaution. Le demi-litre du film vient d’une hypothèse de calcul : trente messages à quinze millilitres, soit 450 ml, arrondis à une petite bouteille. Ce n’est pas une mesure de votre prochaine conversation. Et l’empreinte du café comprend notamment l’eau de pluie utilisée pour faire pousser les grains. L’étude sur l’eau et les modèles d’IA et les données sur les produits agricoles ne comptent pas l’eau de la même façon. C’est la limite du « 280 fois » qu’on entend dans l’accroche.
La huitième version tient en sept images
À 2,20 secondes, le grand titre de l’intro s’efface. Au-dessus de la tasse arrive déjà le sous-titre « votre café de ce matin ». Dans la septième version, on a enlevé le mot « mais » du sous-titre. Ça ne suffisait pas : il restait deux textes à lire en même temps.
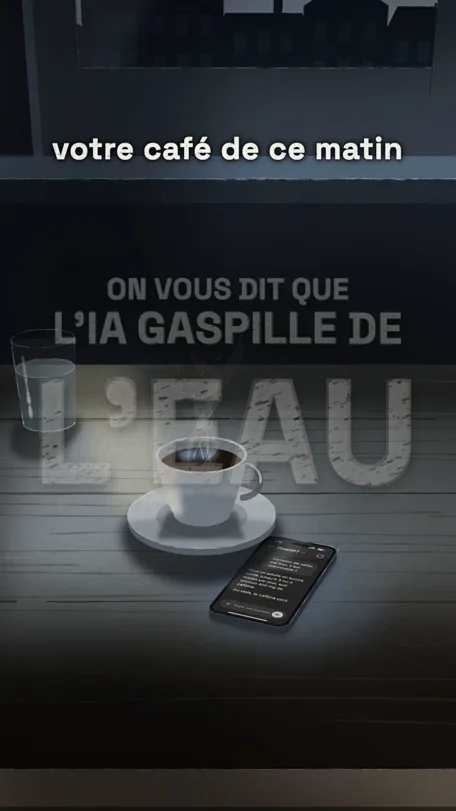
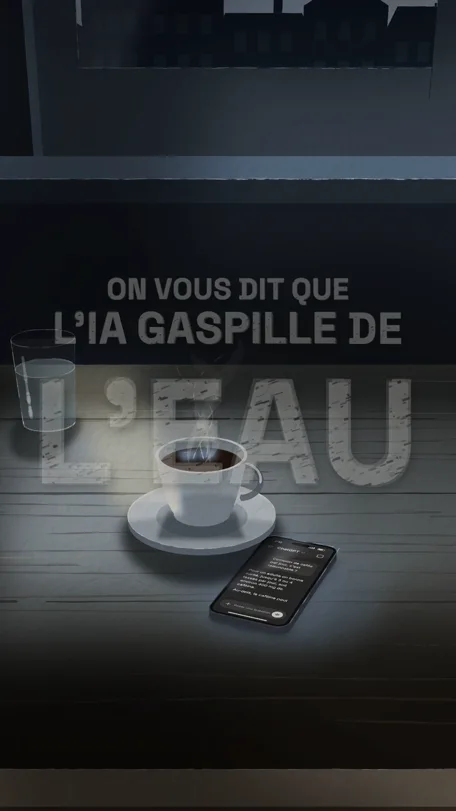
Dans le dernier montage, le sous-titre commence à 2,40 secondes au lieu de 2,17 : sept images de décalage à 30 images par seconde. La règle est désormais écrite dans le code : un sous-titre attend qu’un titre ait fini de disparaître, fondu compris.
La voix et la musique sont identiques. Si vous regardez la V8 seule, vous ne remarquerez probablement rien. C’était précisément le résultat que je cherchais.
Les huit montages, version par version
- V1
- La première animation compte 31 plans ; le champ de coton est difficile à lire dans l’obscurité.
- V2
- Le champ passe au matin. Les cuves remplacent la cuisine dans le plan final.
- V3
- La lumière dépend de la scène. La dernière image devient une vallée où le data center partage le fleuve avec les autres activités.
- V4
- Le calcul s’écrit trait par trait. Les bruitages d’eau se prolongent au changement de plan.
- V5
- Le fleuve perd son grand reflet blanc. Les tuyaux de refroidissement se trouvent désormais sur la phrase qui les explique.
- V6
- Le compteur porte le découpage à 32 plans. La bouteille arrive sur « petite ».
- V7
- Le premier sous-titre commence par « votre café » plutôt que « mais ». Il recouvre encore le titre.
- V8
- Le même sous-titre attend la fin du fondu. Le montage dure 2 min 05.
Voir la vidéo complète publiée le 27 octobre sur YouTube · La regarder sur TikTok
Voix de l’article et provenance
J’ai dicté et repris le texte, choisi la voix à l’écoute et demandé les changements d’image et de son. Claude et ses agents ont écrit le code et produit les montages. Codex a préparé cet article à partir des scripts conservés, des notes de réalisation et des huit exports originaux. Claude Code y a ajouté les étapes et les mesures, tirées des fichiers du projet. Les images montrées ici sont extraites des exports ou des planches de relecture ; les extraits audio viennent des prises et des pistes du projet.
J’ai raconté de la même manière comment j’ai animé Charleroi en aquarelle avec Claude.